
MySQL
数据库
数据库是将大量数据保存起来,通过计算机加工而成的可以进行高效访问的数据集合。用来管理数据库的计算机系统称为数据库管理系统(DBMS)。
特点:
- 持久化存储数据,DB就是一个文件系统
- 方便存储和管理数据
- 使用了统一的方式操作数据库—SQL语言
MySQL
卸载
- 去mysql的安装目录找到my.ini文件,复制datadir="C:/ProgramData/MySQL/MySQL Server
- 在控制面板卸载MySQL
- 删除C:/ProgramData目录下的MySQL文件夹。
配置
- MySQL服务启动
- cmd–>services.msc 打开服务窗口
- 使用管理员打开cmd
- net start mysql:启动MySQL服务
- net stop mysql:关闭MySQL服务
- MySQL登录
- 本地的:mysql -uroot -p密码
- 远程的:mysql -hip地址 -uroot -p连接目标的密码
- mysql --host=ip --user=root --password=连接目标的密码
- MySQL退出
- exit
- quit
- MySQL目录结构
- 安装目录:basedir="D:/develop/MySQL/",配置文件my.ini
- 数据目录:datadir="C:/ProgramData/MySQL/MySQL Server 5.5/Data/"
- 数据库的备份和还原
- mysqldump -u用户名 -p密码 数据库名称 > 保存的路径
- 还原
- 登录数据库
- 创建数据库
- 使用数据库
- 执行文件。source 文件路径
SQL
什么是SQL:Structured Query Language:结构化查询语言。其实就是定义了操作所有关系型数据库的规则,当然不同的数据库软件有各自的特殊语言,称为“方言”。
通用语法
- SQL语句可以单行或多行书写,以分号结尾。
- 可使用空格和缩进来增强语句的可读性。
- SQL语句不区分大小写,关键字建议使用大写。
- SQL语句由子句构成,有些子句是必需的,有些是可选的。
- 3 种注释
- 单行注释: -- 注释内容 或 # 注释内容(mysql 特有)
- 多行注释: /* 注释 */
SQL分类
- DDL(Data Definition Language)数据定义语言
DDL主要用针对是数据库对象进行创建、修改和删除操作,主要包括- CREATE:创建数据库对象
- ALTER:修改数据库对象
- DROP:删除数据库对象
- DML(Data Manipulation Language)数据操作语言
DML主要用于对数据库中的数据进行增加、修改和删除的操作,其主要包括:- INSERT:增加数据
- UPDATE:修改数据
- DELETE:删除数据
- DQL(Data Query Language)数据查询语言
DQL主要用于数据的查询,其基本结构是使用SELECT子句,FROM子句和WHERE子句的组合来查询一条或多条数据。 - DCL(Data Control Language)数据控制语言
DCL用来授予或回收访问数据库的权限。其主要包括:- GRANT:授予用户某种权限
- REVOKE:回收授予的某种权限
- TCL(Transaction Control Language)事务控制语言
用于数据库的事务管理。其主要包括:- START TRANSACTION:开启事务
- COMMIT:提交事务
- ROLLBACK:回滚事务
- SET TRANSACTION:设置事务的属性

操作数据库、表
操作数据库:
-
Create:创建
-
创建数据库
create database 数据库名称; -
创建数据库,判断不存在,再创建
create database if not exists 数据库名称; -
创建数据库,并指定字符集
create database 数据库名称 character set 字符集名;
-
-
Retrieve:取出
- 查看所有数据库的名称
show databases; - 查询某个数据库的创建语句
show create database 数据库名称;
- 查看所有数据库的名称
-
Alter:修改
- 修改数据库的字符集
alter database 数据库名称 character set 字符集名称;
- 修改数据库的字符集
-
Drop:删除
- 删除数据库
drop database 数据库名称; - 判断数据库存在,再删除
drop database if exists 数据库名称;
- 删除数据库
-
使用数据库
- 查询正在使用的数据库名称
select database(); - 使用数据库
use 数据库名称;
- 查询正在使用的数据库名称
操作表:
-
C(Create):创建
-
语法:
create table 表名(
? 列名1 数据类型1,
? 列名2 数据类型2,
? ……
? 列名n 数据类型n
);
-
类型:
- 整型int
- 浮点型double
height double(5,2); - 日期date,只含有年月日,yyyy/MM/dd
- 日期datetime,含有年月日时分秒,yyyy/MM/dd HH:mm:ss
- 时间戳类型timestamp,包含年月日时分秒,此字段如果不赋值,或赋值为null,则默认使用系统当前时间自动赋值
- 字符串varchar
name varchar(20):保存姓名,最大20个字符(汉字算一个字符),字符串用单引号括起来,MySQL也可以用双引号
-
复制表
create table 表名 like 被复制的表名;
-
-
R(Retrieve):取出
- 取出某个数据库中所有的表名
show tables; - 查看表的创建语句
show create table 表名; - 取出表的所有字段
desc 表名; describe
asc 表名; ascend升序,MySQL不支持
- 取出某个数据库中所有的表名
-
Alter:修改
- 修改表名
rename table 表名 to 新的表名; - 修改表的字符集
alter table 表名 character set 字符集名称; - 添加一列
alter table 表名 add 列名 数据类型; - 添加一列放在最前面
alter table 表名 add 列名 数据类型 first; - 添加一列放在gender列的后面
alter table 表名 add 列名 数据类型 after gender; - 修改列名称 类型
alter table 表名 change 列名 新列名 新数据类型;
alter table 表名 modify 列名 新数据类型; 只改数据类型 - 删除列
alter table 表名 drop 列名;
- 修改表名
-
Drop:删除
drop table 表名;
drop table if exists 表名;
增删改表中数据
-
INSERT添加数据
-
语法
insert into 表名(列名1,列名2,...列名n) values(值1,值2,...值n); -
注意
列名和值要一一对应。
如果表名后无列名,则默认给所有列添加值:insert into 表名 values(值1,值2,...值n);
除了数字类型,其他类型需要使用引号(单双都可以)引起来
-
-
DELETE删除数据
- 语法
delete from 表名 [where 条件] - 注意
如果不加条件,则删除表中所有记录。
如果要删除所有记录- delete from 表名; 不推荐,有多少条记录就会执行多少次删除操作
- TRUNCATE TABLE 表名; 推荐,效率更高。先删除表,然后再创建一张一样的空表。
- 语法
-
UPDATE更新数据
-
语法
update 表名 set 列名1 = 值1, 列名2 = 值2,... [where 条件];
update student set name = ‘jack‘ where id = 5; -
注意
如果不加任何条件,则会将表中所有记录全部修改。
-
查询表中数据
- 语法
select
字段列表
from
表名列表
where
条件列表
group by
分组字段
having
分组之后的条件
order by
排序
limit
分页限定 - 简单查询
- 多个字段的查询
select 字段名1,字段名2... from 表名; - 查询所有字段
select * from 表名; - 去除重复
distinct - 计算列
一般可以使用四则运算计算一些列的值。null参与的运算,计算结果都为null
ifnull(表达式1,表达式2):如果表达式1是null,就把它替换成表达式2 - 起别名
用as,as也可以省略
- 多个字段的查询
- 过滤
- where子句后跟条件
- 过滤条件
- 比较运算符
- BETWEEN...AND
- IN( 集合)
- IS NULL,判断某个值等于null不可以使用=
- IS NOT NULL
- and 或 &&
- or 或 ||
- not 或 !
- 模糊查询
- 占位符
- _:单个任意字符
查询姓名第二个字是化的人:select * from student where name like “_化%” - %:多个任意字符
查询名字中有德的人:select * from student where name like “%德%”;
- _:单个任意字符
- 占位符
DQL高级
-
排序查询
语法:order by 子句
order by 列名1 排序方式1,列名2 排序方式2...
排序方式:asc升序,默认的,一般不指定。desc降序 -
聚合函数:将一个字段取出,对里面的数据进行计算
- count(field):计算个数
一般选非空的列:主键。因为会排除null值。 - max
- min
- sum
- avg
- count(field):计算个数
-
分组查询
语法:group by field
注意:分组之后可以查询的字段:分组字段、聚合函数- where 和 having 的区别:
- where 在分组之前进行限定,如果不满足条件,则不参与分组。having在分组之后进行限定,如果不满足结果,则不会被查询出来
- where 后不可以跟聚合函数,having可以进行聚合函数的判断
-- 按照性别分组。分别查询男、女同学的平均分 select sex, avg(math) from student group by sex; -- 按照性别分组。分别查询男、女同学的平均分,人数 select sex, avg(math), count(id) from student group by sex; -- 按照性别分组。分别查询男、女同学的平均分,人数 要求:分数低于70分的人,不参与分组 select sex,avg(math),count(id) from student where math > 70 group by sex; -- 按照性别分组。分别查询男、女同学的平均分,人数 要求:分数低于70分的人,不参与分组,分组之后。人数要大于2个人 select sex,avg(math),count(id) from student where math >70 group by sex having count(id)>2; - where 和 having 的区别:
-
分页查询
语法: limit 显示的行数 offset 开始的索引; MySQL的方言:limit 开始的索引, 显示的行数;
公式:开始的索引=(当前页码 -1 )*每页显示的条数-- 显示名字的第一页,每页3行,下面三条结果相同 select name from student limit 0,3; select name from student limit 3; select name from student limit 3 offset 0;
约束
约束就是对表中的数据进行限制,保证数据的正确性、有效性和完整性。
分类
-
非空约束:not null
-
创建表时添加约束
CREATE TABLE stu( id INT, NAME VARCHAR(20) NOT NULL -- name为非空 ); -
创建表完后,添加非空约束
ALTER TABLE stu MODIFY NAME VARCHAR(20) NOT NULL; -
删除name的非空约束
ALTER TABLE stu MODIFY NAME VARCHAR(20);
-
-
唯一约束:unique,某一列的值不能重复
-
唯一约束可以有NULL值,但是只能有一条记录为null
-
在创建表时,添加唯一约束
CREATE TABLE stu( id INT, phone_number VARCHAR(20) UNIQUE -- 手机号 ); -
删除唯一约束
ALTER TABLE stu DROP INDEX phone_number; -
在表创建完后,添加唯一约束
ALTER TABLE stu MODIFY phone_number VARCHAR(20) UNIQUE;
-
-
主键约束:primary key
-
注意
- 含义:非空且唯一
- 一张表只能有一个字段为主键
- 主键就是表中记录的唯一标识
-
在创建表时,添加主键约束
create table stu(
id int primary key,-- 给id添加主键约束
name varchar(20)
);
或者
create table stu(
id int ,
name varchar(20),? constraint stu_pk primary key (id)
); -
删除主键
-- 错误 alter table stu modify id int ;
ALTER TABLE stu DROP PRIMARY KEY; -
创建完表后,添加主键
ALTER TABLE stu MODIFY id INT PRIMARY KEY;
-
-
自动增长
- 概念:如果某一列是数值类型的,使用 auto_increment 可以来完成值的自动增长
- 在创建表时,添加主键约束,并且完成主键自增长
create table stu(
id int primary key auto_increment-- 给id添加主键约束
); - 删除自动增长
ALTER TABLE stu MODIFY id INT; - 添加自动增长
ALTER TABLE stu MODIFY id INT AUTO_INCREMENT;
-
检查约束:check。限制某些字段的取值范围
create table student{ gender varchar(5) CHECK (gender in (‘男‘,‘女‘)) }; -- 也可以使用枚举 create table student{ gender varchar(5) enum(‘男‘,‘女‘) } -
默认值约束:default
-
外键约束:foreign key,约束表与表之间的关系。外键约束可以使两张表紧密的结合起来,特别是针对修改或者删除的级联操作时,会保证数据的完整性。外键是指表中某个字段的值依赖于另一张表中某个字段的值,而被依赖的字段必须具有主键约束或者唯一约束。被依赖的表我们通常称之为父表或者主表,设置外键约束的表称为子表或者从表。
- 在创建表时,可以添加外键
create table 表名(
...
constraint 外键名 foreign key (外键列名称) references 主表名称(主表列名称)
); - 删除外键
ALTER TABLE 表名 DROP FOREIGN KEY 外键名; - 创建表之后,添加外键
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段名称) REFERENCES 主表名称(主表列名称);
- 在创建表时,可以添加外键
-
级联操作
- 添加级联操作
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段名称) REFERENCES 主表名称(主表列名称) ON UPDATE CASCADE ON DELETE CASCADE ; - 分类:
- 级联更新:ON UPDATE CASCADE
- 级联删除:ON DELETE CASCADE,很危险,通常不用
- 添加级联操作
多表查询
准备表
-
部门表
CREATE TABLE dept( id INT PRIMARY KEY AUTO_INCREMENT, NAME VARCHAR(20) ); INSERT INTO dept (NAME) VALUES (‘开发部‘),(‘市场部‘),(‘财务部‘); -
员工表
CREATE TABLE emp (
    id INT PRIMARY KEY AUTO_INCREMENT,
    NAME VARCHAR(10),
    gender CHAR(1), -- 性别
    salary DOUBLE, -- 工资
    join_date DATE, -- 入职日期
    dept_id INT,
    FOREIGN KEY (dept_id) REFERENCES dept(id) -- 外键,关联部门表(部门表的主键)
);
	INSERT INTO emp(NAME,gender,salary,join_date,dept_id) VALUES(‘孙悟空‘,‘男‘,7200,‘2013-02-24‘,1);
	INSERT INTO emp(NAME,gender,salary,join_date,dept_id) VALUES(‘猪八戒‘,‘男‘,3600,‘2010-12-02‘,2);
	INSERT INTO emp(NAME,gender,salary,join_date,dept_id) VALUES(‘唐僧‘,‘男‘,9000,‘2008-08-08‘,2);
	INSERT INTO emp(NAME,gender,salary,join_date,dept_id) VALUES(‘白骨精‘,‘女‘,5000,‘2015-10-07‘,3);
	INSERT INTO emp(NAME,gender,salary,join_date,dept_id) VALUES(‘蜘蛛精‘,‘女‘,4500,‘2011-03-14‘,1);
查询语法:
select 列名列表 from 表名列表 where....
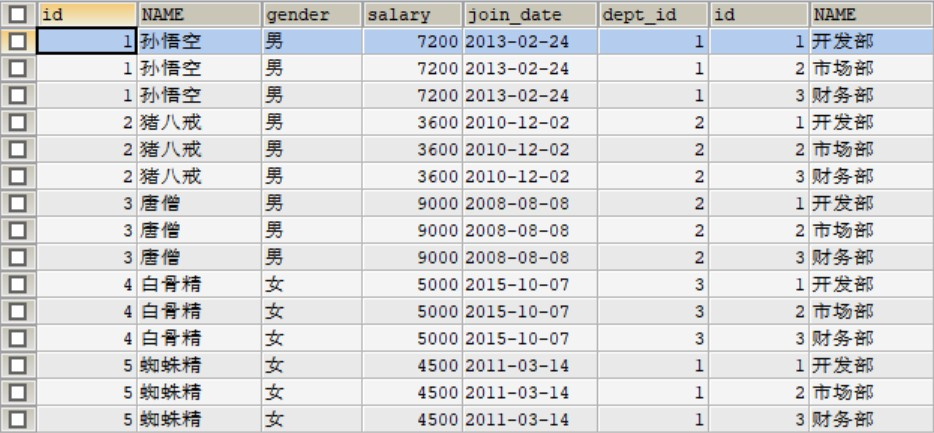
如果从两个表名中查询某字段,返回两个表字段的笛卡尔积。下图看出笛卡尔积有很多重复内容,需要去除。
select * from emp,dept;
多表查询分类
-
内连接查询:查询两表的交集
-
隐式内连接:使用where条件消除无用数据
-- 查询所有员工信息和对应的部门信息 SELECT * FROM emp,dept WHERE emp.`dept_id`=dept.`id`; -- 查询员工表的名称,性别。部门表的名称 SELECT emp.`NAME`,emp.`gender`,dept.`NAME` FROM emp,dept WHERE emp.`dept_id`=dept.`id`; -- 常用格式 SELECT t1.name, -- 员工表的姓名 t1.gender,-- 员工表的性别 t2.name -- 部门表的名称 FROM emp t1,-- 起别名 dept t2 WHERE t1.`dept_id` = t2.`id`; -
显式内连接
select 字段列表 from 表名1 [inner] join 表名2 on 条件
on子句称为连接条件,其实和where子句的过滤条件用法一样。SELECT * FROM emp INNER JOIN dept ON emp.`dept_id` = dept.`id`; SELECT * FROM emp JOIN dept ON emp.`dept_id` = dept.`id`; -- 连接三个及以上的表,注意多表连接时顺序随意 select a.account_id, c.fed_id, e.name from employee e inner join account a on e.emp_id = a.open_emp_id inner join customer c on a.cust_id = c.cust_id where c.cust_type_cd = ‘B‘; -- 自连接:查询员工对应的主管,因为主管也是员工,所以使用员工表两次 SELECT e.`name` ‘员工名字‘, mgr.`name` ‘主管名字‘ FROM employee e INNER JOIN employee mgr -- 员工表使用两次,需要起两个别名 ON e.`superior_emp_id`=mgr.`emp_id`;
-
-
外连接查询
-
左外连接:查询的是左表所有数据以及其交集部分。
select 字段列表 from 表1 left [outer] join 表2 on 条件;-- 查询所有员工信息,如果员工有部门,则查询部门名称,没有部门,则不显示部门名称 SELECT t1.*,t2.`name` FROM emp t1 LEFT JOIN dept t2 ON t1.`dept_id` = t2.`id`; -
右外连接:查询的是右表所有数据以及其交集部分。
select 字段列表 from 表1 right [outer] join 表2 on 条件;SELECT * FROM dept t2 RIGHT JOIN emp t1 ON t1.`dept_id` = t2.`id`;
-
-
子查询
-
概念:查询中嵌套查询,称嵌套查询为子查询。
-- 查询工资最高的员工信息 SELECT * FROM emp WHERE salary=(SELECT MAX(salary) FROM emp); -
子查询分类:
-
子查询结果是单行单列的:查询可以作为条件,使用运算符去判断。
-- 查询员工工资小于平均工资的人 SELECT * FROM emp WHERE salary < (SELECT AVG(salary) FROM emp); -
查询的结果是多行单列的:子查询可以作为条件,使用运算符in来判断
-- 查询‘财务部‘和‘市场部‘所有的员工信息 SELECT * FROM emp WHERE dept_id IN (SELECT id FROM dept WHERE NAME = ‘财务部‘ OR NAME = ‘市场部‘); -
子查询的结果是多行多列的:
-
-
视图
- 视图是一种虚拟存在的数据表
- 这个虚拟的表并不在数据库中实际存在
- 作用是将一些比较复杂的查询语句的结果,封装到一个虚拟表中。后期再有相同复杂查询时,直接查询这张虚拟表即可
- 说白了,视图就是将一条SELECT查询语句的结果封装到了一个虚拟表中,所以我们在创建视图的时候,工作重心就要放在这条SELECT查询语句上
-- 视图创建
CREATE VIEW 视图名称 [(列名列表)] AS 查询语句;
-- 查询视图创建语句
SHOW CREATE VIEW 视图名称;
-- 修改数据 。注意通过视图修改数据,会自动修改源表的数据
UPDATE 视图名称 SET 列名=值 WHERE 条件;
-- 修改视图表的结构
ALTER VIEW 视图名称 [(列名列表)] AS 查询语句;
-- 删除视图
DROP VIEW [IF EXISTS] 视图名称;
示例:
-- 查询001号部门的员工信息并生成视图
create view myview001
as
select empid,empname,job,empsalary from emp
where depid=001;
-- 查看视图
select * from myview001;
函数
SQL中的函数分为存储过程和存储函数。二者的区别是存储函数必须有返回值,存储过程可以没有返回值
函数的优点
- 减少网络流量,存储过程和函数位于服务器上,调用的时候只需要传递名称和参数即可
- 减少数据在数据库和应用服务器之间的传输,可以提高数据处理的效率
- 将一些业务逻辑在数据库层面来实现,可以减少代码层面的业务处理
创建存储过程
- 语法
/*
	DELIMITER用来声明sql语句的分隔符,告诉MySQL该段命令已经结束!
	sql语句默认的分隔符是分号,但是有的时候我们需要多条sql语句,不希望分号作为结束标识。
	这个时候就可以使用DELIMITER来指定分隔符了!
*/
-- 修改分隔符为$
DELIMITER $

-- 标准语法
CREATE PROCEDURE 存储过程名称(参数...)
BEGIN
	sql语句;
END$

-- 修改分隔符为分号
DELIMITER ;
- 创建存储过程
-- 修改分隔符为$
DELIMITER $

-- 创建存储过程,封装分组查询学生总成绩的sql语句
CREATE PROCEDURE stu_group()
BEGIN
	SELECT gender,SUM(score) getSum FROM student GROUP BY gender ORDER BY getSum ASC;
END$

-- 修改分隔符为分号
DELIMITER ;
调用存储过程
-- 标准语法
CALL 存储过程名称(实际参数);

-- 调用stu_group存储过程
CALL stu_group();
查看存储过程
-- 查询数据库中所有的存储过程 标准语法
SELECT * FROM mysql.proc WHERE db=‘数据库名称‘;
删除存储过程
-- 标准语法
DROP PROCEDURE [IF EXISTS] 存储过程名称;

-- 删除stu_group存储过程
DROP PROCEDURE stu_group;
变量的使用
- 定义变量
-- 标准语法
DECLARE 变量名 数据类型 [DEFAULT 默认值];
-- 注意: DECLARE定义的是局部变量,只能用在BEGIN END范围之内

-- 定义一个int类型变量、并赋默认值为10
DELIMITER $

CREATE PROCEDURE pro_test1()
BEGIN
	DECLARE num INT DEFAULT 10;   -- 定义变量
	SELECT num;                   -- 查询变量
END$

DELIMITER ;

-- 调用pro_test1存储过程
CALL pro_test1();
- 变量的赋值1
-- 标准语法
SET 变量名 = 变量值;

-- 定义字符串类型变量,并赋值
DELIMITER $

CREATE PROCEDURE pro_test2()
BEGIN
	DECLARE NAME VARCHAR(10);   -- 定义变量
	SET NAME = ‘存储过程‘;       -- 为变量赋值
	SELECT NAME;                -- 查询变量
END$

DELIMITER ;

-- 调用pro_test2存储过程
CALL pro_test2();
- 变量的赋值2
-- 标准语法
SELECT 列名 INTO 变量名 FROM 表名 [WHERE 条件];

-- 定义两个int变量,用于存储男女同学的总分数
DELIMITER $

CREATE PROCEDURE pro_test3()
BEGIN
	DECLARE men,women INT;  -- 定义变量
	SELECT SUM(score) INTO men FROM student WHERE gender=‘男‘;    -- 计算男同学总分数赋值给men
	SELECT SUM(score) INTO women FROM student WHERE gender=‘女‘;  -- 计算女同学总分数赋值给women
	SELECT men,women;           -- 查询变量
END$

DELIMITER ;

-- 调用pro_test3存储过程
CALL pro_test3();
if语句的使用
- 标准语法
-- 标准语法
IF 判断条件1 THEN 执行的sql语句1;
[ELSEIF 判断条件2 THEN 执行的sql语句2;]
...
[ELSE 执行的sql语句n;]
END IF;
- 案例演示
/*
	定义一个int变量,用于存储班级总成绩
	定义一个varchar变量,用于存储分数描述
	根据总成绩判断:
		380分及以上    学习优秀
		320 ~ 380     学习不错
		320以下       学习一般
*/
DELIMITER $

CREATE PROCEDURE pro_test4()
BEGIN
	-- 定义总分数变量
	DECLARE total INT;
	-- 定义分数描述变量
	DECLARE description VARCHAR(10);
	-- 为总分数变量赋值
	SELECT SUM(score) INTO total FROM student;
	-- 判断总分数
	IF total >= 380 THEN
		SET description = ‘学习优秀‘;
	ELSEIF total >= 320 AND total < 380 THEN
		SET description = ‘学习不错‘;
	ELSE
		SET description = ‘学习一般‘;
	END IF;

	-- 查询总成绩和描述信息
	SELECT total,description;
END$

DELIMITER ;

-- 调用pro_test4存储过程
CALL pro_test4();
参数的传递
- 参数传递的语法
DELIMITER $

-- 标准语法
CREATE PROCEDURE 存储过程名称([IN|OUT|INOUT] 参数名 数据类型)
BEGIN
	执行的sql语句;
END$
/*
	IN:代表输入参数,需要由调用者传递实际数据。默认的
	OUT:代表输出参数,该参数可以作为返回值
	INOUT:代表既可以作为输入参数,也可以作为输出参数
*/
DELIMITER ;
-
输入参数
- 标准语法
DELIMITER $ -- 标准语法 CREATE PROCEDURE 存储过程名称(IN 参数名 数据类型) BEGIN 执行的sql语句; END$ DELIMITER ;- 案例演示
/* 输入总成绩变量,代表学生总成绩 定义一个varchar变量,用于存储分数描述 根据总成绩判断: 380分及以上 学习优秀 320 ~ 380 学习不错 320以下 学习一般 */ DELIMITER $ CREATE PROCEDURE pro_test5(IN total INT) BEGIN -- 定义分数描述变量 DECLARE description VARCHAR(10); -- 判断总分数 IF total >= 380 THEN SET description = ‘学习优秀‘; ELSEIF total >= 320 AND total < 380 THEN SET description = ‘学习不错‘; ELSE SET description = ‘学习一般‘; END IF; -- 查询总成绩和描述信息 SELECT total,description; END$ DELIMITER ; -- 调用pro_test5存储过程 CALL pro_test5(390); CALL pro_test5((SELECT SUM(score) FROM student)); -
输出参数
- 标准语法
DELIMITER $ -- 标准语法 CREATE PROCEDURE 存储过程名称(OUT 参数名 数据类型) BEGIN 执行的sql语句; END$ DELIMITER ;- 案例演示
/* 输入总成绩变量,代表学生总成绩 输出分数描述变量,代表学生总成绩的描述 根据总成绩判断: 380分及以上 学习优秀 320 ~ 380 学习不错 320以下 学习一般 */ DELIMITER $ CREATE PROCEDURE pro_test6(IN total INT,OUT description VARCHAR(10)) BEGIN -- 判断总分数 IF total >= 380 THEN SET description = ‘学习优秀‘; ELSEIF total >= 320 AND total < 380 THEN SET description = ‘学习不错‘; ELSE SET description = ‘学习一般‘; END IF; END$ DELIMITER ; -- 调用pro_test6存储过程 CALL pro_test6(310,@description); -- 查询总成绩描述 SELECT @description;- 小知识
@变量名:  这种变量要在变量名称前面加上“@”符号,叫做用户会话变量,代表整个会话过程他都是有作用的,这个类似于全局变量一样。
@@变量名: 这种在变量前加上 "@@" 符号, 叫做系统变量
case语句的使用
- 标准语法1
-- 标准语法
CASE 表达式
WHEN 值1 THEN 执行sql语句1;
[WHEN 值2 THEN 执行sql语句2;]
...
[ELSE 执行sql语句n;]
END CASE;
- 标准语法2
-- 标准语法
CASE
WHEN 判断条件1 THEN 执行sql语句1;
[WHEN 判断条件2 THEN 执行sql语句2;]
...
[ELSE 执行sql语句n;]
END CASE;
- 案例演示
/*
	输入总成绩变量,代表学生总成绩
	定义一个varchar变量,用于存储分数描述
	根据总成绩判断:
		380分及以上  学习优秀
		320 ~ 380    学习不错
		320以下      学习一般
*/
DELIMITER $

CREATE PROCEDURE pro_test7(IN total INT)
BEGIN
	-- 定义变量
	DECLARE description VARCHAR(10);
	-- 使用case判断
	CASE
	WHEN total >= 380 THEN
		SET description = ‘学习优秀‘;
	WHEN total >= 320 AND total < 380 THEN
		SET description = ‘学习不错‘;
	ELSE
		SET description = ‘学习一般‘;
	END CASE;

	-- 查询分数描述信息
	SELECT description;
END$

DELIMITER ;

-- 调用pro_test7存储过程
CALL pro_test7(390);
CALL pro_test7((SELECT SUM(score) FROM student));
while循环
- 标准语法
-- 标准语法
初始化语句;
WHILE 条件判断语句 DO
	循环体语句;
	条件控制语句;
END WHILE;
- 案例演示
/*
	计算1~100之间的偶数和
*/
DELIMITER $

CREATE PROCEDURE pro_test8()
BEGIN
	-- 定义求和变量
	DECLARE result INT DEFAULT 0;
	-- 定义初始化变量
	DECLARE num INT DEFAULT 1;
	-- while循环
	WHILE num <= 100 DO
		-- 偶数判断
		IF num%2=0 THEN
			SET result = result + num; -- 累加
		END IF;

		-- 让num+1
		SET num = num + 1;
	END WHILE;

	-- 查询求和结果
	SELECT result;
END$

DELIMITER ;

-- 调用pro_test8存储过程
CALL pro_test8();
repeat循环
- 标准语法
-- 标准语法
初始化语句;
REPEAT
	循环体语句;
	条件控制语句;
	UNTIL 条件判断语句
END REPEAT;

-- 注意:repeat循环是条件满足则停止。while循环是条件满足则执行
- 案例演示
/*
	计算1~10之间的和
*/
DELIMITER $

CREATE PROCEDURE pro_test9()
BEGIN
	-- 定义求和变量
	DECLARE result INT DEFAULT 0;
	-- 定义初始化变量
	DECLARE num INT DEFAULT 1;
	-- repeat循环
	REPEAT
		-- 累加
		SET result = result + num;
		-- 让num+1
		SET num = num + 1;

		-- 停止循环
		UNTIL num>10
	END REPEAT;

	-- 查询求和结果
	SELECT result;
END$

DELIMITER ;

-- 调用pro_test9存储过程
CALL pro_test9();
loop循环
- 标准语法
-- 标准语法
初始化语句;
[循环名称:] LOOP
	条件判断语句
		[LEAVE 循环名称;]
	循环体语句;
	条件控制语句;
END LOOP 循环名称;

-- 注意:loop可以实现简单的循环,但是退出循环需要使用其他的语句来定义。我们可以使用leave语句完成!
--      如果不加退出循环的语句,那么就变成了死循环。
- 案例演示
/*
	计算1~10之间的和
*/
DELIMITER $

CREATE PROCEDURE pro_test10()
BEGIN
	-- 定义求和变量
	DECLARE result INT DEFAULT 0;
	-- 定义初始化变量
	DECLARE num INT DEFAULT 1;
	-- loop循环
	l:LOOP
		-- 条件成立,停止循环
		IF num > 10 THEN
			LEAVE l;
		END IF;

		-- 累加
		SET result = result + num;
		-- 让num+1
		SET num = num + 1;
	END LOOP l;

	-- 查询求和结果
	SELECT result;
END$

DELIMITER ;

-- 调用pro_test10存储过程
CALL pro_test10();
游标
-
游标的概念
- 游标可以遍历返回的多行结果,每次拿到一整行数据
- 在存储过程和函数中可以使用游标对结果集进行循环的处理
- 简单来说游标就类似于集合的迭代器遍历
- MySQL中的游标只能用在存储过程和函数中
-
游标的语法
- 创建游标
-- 标准语法 DECLARE 游标名称 CURSOR FOR 查询sql语句;- 打开游标
-- 标准语法 OPEN 游标名称;- 使用游标获取数据
-- 标准语法 FETCH 游标名称 INTO 变量名1,变量名2,...;- 关闭游标
-- 标准语法 CLOSE 游标名称; -
游标的基本使用
-- 创建stu_score表
CREATE TABLE stu_score(
	id INT PRIMARY KEY AUTO_INCREMENT,
	score INT
);

/*
	将student表中所有的成绩保存到stu_score表中
*/
DELIMITER $

CREATE PROCEDURE pro_test11()
BEGIN
	-- 定义成绩变量
	DECLARE s_score INT;
	-- 创建游标,查询所有学生成绩数据
	DECLARE stu_result CURSOR FOR SELECT score FROM student;

	-- 开启游标
	OPEN stu_result;

	-- 使用游标,遍历结果,拿到第1行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第2行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第3行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第4行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 关闭游标
	CLOSE stu_result;
END$

DELIMITER ;

-- 调用pro_test11存储过程
CALL pro_test11();

-- 查询stu_score表
SELECT * FROM stu_score;


-- ===========================================================
/*
	出现的问题:
		student表中一共有4条数据,我们在游标遍历了4次,没有问题!
		但是在游标中多遍历几次呢?就会出现问题
*/
DELIMITER $

CREATE PROCEDURE pro_test11()
BEGIN
	-- 定义成绩变量
	DECLARE s_score INT;
	-- 创建游标,查询所有学生成绩数据
	DECLARE stu_result CURSOR FOR SELECT score FROM student;

	-- 开启游标
	OPEN stu_result;

	-- 使用游标,遍历结果,拿到第1行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第2行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第3行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第4行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 使用游标,遍历结果,拿到第5行数据
	FETCH stu_result INTO s_score;
	-- 将数据保存到stu_score表中
	INSERT INTO stu_score VALUES (NULL,s_score);

	-- 关闭游标
	CLOSE stu_result;
END$

DELIMITER ;

-- 调用pro_test11存储过程
CALL pro_test11();

-- 查询stu_score表,虽然数据正确,但是在执行存储过程时会报错
SELECT * FROM stu_score;
- 游标的优化使用(配合循环使用)
/*
	当游标结束后,会触发游标结束事件。我们可以通过这一特性来完成循环操作
	加标记思想:
		1.定义一个变量,默认值为0(意味着有数据)
		2.当游标结束后,将变量值改为1(意味着没有数据了)
*/
-- 1.定义一个变量,默认值为0(意味着有数据)
DECLARE flag INT DEFAULT 0;
-- 2.当游标结束后,将变量值改为1(意味着没有数据了)
DECLARE EXIT HANDLER FOR NOT FOUND SET flag = 1;
/*
	将student表中所有的成绩保存到stu_score表中
*/
DELIMITER $

CREATE PROCEDURE pro_test12()
BEGIN
	-- 定义成绩变量
	DECLARE s_score INT;
	-- 定义标记变量
	DECLARE flag INT DEFAULT 0;
	-- 创建游标,查询所有学生成绩数据
	DECLARE stu_result CURSOR FOR SELECT score FROM student;
	-- 游标结束后,将标记变量改为1
	DECLARE EXIT HANDLER FOR NOT FOUND SET flag = 1;

	-- 开启游标
	OPEN stu_result;

	-- 循环使用游标
	REPEAT
		-- 使用游标,遍历结果,拿到数据
		FETCH stu_result INTO s_score;
		-- 将数据保存到stu_score表中
		INSERT INTO stu_score VALUES (NULL,s_score);
	UNTIL flag=1
	END REPEAT;

	-- 关闭游标
	CLOSE stu_result;
END$

DELIMITER ;

-- 调用pro_test12存储过程
CALL pro_test12();

-- 查询stu_score表
SELECT * FROM stu_score;
存储函数
-
存储函数和存储过程是非常相似的。存储函数可以做的事情,存储过程也可以做到!
-
存储函数有返回值,存储过程没有返回值(参数的out其实也相当于是返回数据了)
-
标准语法
- 创建存储函数
DELIMITER $ -- 标准语法 CREATE FUNCTION 函数名称([参数 数据类型]) RETURNS 返回值类型 BEGIN 执行的sql语句; RETURN 结果; END$ DELIMITER ;- 调用存储函数
-- 标准语法 SELECT 函数名称(实际参数);- 删除存储函数
-- 标准语法 DROP FUNCTION 函数名称; -
案例演示
/*
	定义存储函数,获取学生表中成绩大于95分的学生数量
*/
DELIMITER $

CREATE FUNCTION fun_test1()
RETURNS INT
BEGIN
	-- 定义统计变量
	DECLARE result INT;
	-- 查询成绩大于95分的学生数量,给统计变量赋值
	SELECT COUNT(*) INTO result FROM student WHERE score > 95;
	-- 返回统计结果
	RETURN result;
END$

DELIMITER ;

-- 调用fun_test1存储函数
SELECT fun_test1();
触发器
- 触发器是与表有关的数据库对象,可以在 insert/update/delete 之前或之后,触发并执行触发器中定义的SQL语句。触发器的这种特性可以协助应用在数据库端确保数据的完整性 、日志记录 、数据校验等操作 。
- 使用别名 NEW 和 OLD 来引用触发器中发生变化的记录内容,这与其他的数据库是相似的。现在触发器还只支持行级触发,不支持语句级触发。
| 触发器类型 | OLD的含义 | NEW的含义 |
|---|---|---|
| INSERT 型触发器 | 无 (因为插入前状态无数据) | NEW 表示将要或者已经新增的数据 |
| UPDATE 型触发器 | OLD 表示修改之前的数据 | NEW 表示将要或已经修改后的数据 |
| DELETE 型触发器 | OLD 表示将要或者已经删除的数据 | 无 (因为删除后状态无数据) |
创建触发器
- 标准语法
DELIMITER $

CREATE TRIGGER 触发器名称
BEFORE|AFTER INSERT|UPDATE|DELETE
ON 表名
[FOR EACH ROW]  -- 行级触发器
BEGIN
	触发器要执行的功能;
END$

DELIMITER ;
-
触发器演示。通过触发器记录账户表的数据变更日志。包含:增加、修改、删除
- 创建账户表
-- 创建db9数据库 CREATE DATABASE db9; -- 使用db9数据库 USE db9; -- 创建账户表account CREATE TABLE account( id INT PRIMARY KEY AUTO_INCREMENT, -- 账户id NAME VARCHAR(20), -- 姓名 money DOUBLE -- 余额 ); -- 添加数据 INSERT INTO account VALUES (NULL,‘张三‘,1000),(NULL,‘李四‘,2000);- 创建日志表
-- 创建日志表account_log CREATE TABLE account_log( id INT PRIMARY KEY AUTO_INCREMENT, -- 日志id operation VARCHAR(20), -- 操作类型 (insert update delete) operation_time DATETIME, -- 操作时间 operation_id INT, -- 操作表的id operation_params VARCHAR(200) -- 操作参数 );- 创建INSERT触发器
-- 创建INSERT触发器 DELIMITER $ CREATE TRIGGER account_insert AFTER INSERT ON account FOR EACH ROW BEGIN INSERT INTO account_log VALUES (NULL,‘INSERT‘,NOW(),new.id,CONCAT(‘插入后{id=‘,new.id,‘,name=‘,new.name,‘,money=‘,new.money,‘}‘)); END$ DELIMITER ; -- 向account表添加记录 INSERT INTO account VALUES (NULL,‘王五‘,3000); -- 查询account表 SELECT * FROM account; -- 查询日志表 SELECT * FROM account_log;- 创建UPDATE触发器
-- 创建UPDATE触发器 DELIMITER $ CREATE TRIGGER account_update AFTER UPDATE ON account FOR EACH ROW BEGIN INSERT INTO account_log VALUES (NULL,‘UPDATE‘,NOW(),new.id,CONCAT(‘修改前{id=‘,old.id,‘,name=‘,old.name,‘,money=‘,old.money,‘}‘,‘修改后{id=‘,new.id,‘,name=‘,new.name,‘,money=‘,new.money,‘}‘)); END$ DELIMITER ; -- 修改account表 UPDATE account SET money=3500 WHERE id=3; -- 查询account表 SELECT * FROM account; -- 查询日志表 SELECT * FROM account_log;- 创建DELETE触发器
-- 创建DELETE触发器
DELIMITER $

CREATE TRIGGER account_delete
AFTER DELETE
ON account
FOR EACH ROW
BEGIN
	INSERT INTO account_log VALUES (NULL,‘DELETE‘,NOW(),old.id,CONCAT(‘删除前{id=‘,old.id,‘,name=‘,old.name,‘,money=‘,old.money,‘}‘));
END$

DELIMITER ;

-- 删除account表数据
DELETE FROM account WHERE id=3;

-- 查询account表
SELECT * FROM account;

-- 查询日志表
SELECT * FROM account_log;
查看触发器
-- 标准语法
SHOW TRIGGERS;

-- 查看触发器
SHOW TRIGGERS;
删除触发器
-- 标准语法
DROP TRIGGER 触发器名称;

-- 删除DELETE触发器
DROP TRIGGER account_delete;
触发器的总结
- 触发器是与表有关的数据库对象
- 可以在 insert/update/delete 之前或之后,触发并执行触发器中定义的SQL语句
- 触发器的这种特性可以协助应用在数据库端确保数据的完整性 、日志记录 、数据校验等操作
- 使用别名 NEW 和 OLD 来引用触发器中发生变化的记录内容
事务
概念:如果一个包含多个步骤的业务操作,被事务管理,那么这些操作要么同时成功,要么同时失败。
操作:
- 开启事务:记录回滚点,并通知服务器,将要执行一组操作,要么同时成功、要么同时失败
- 执行sql语句:执行具体的一条或多条sql语句
- 结束事务(提交|回滚)
- 提交:没出现问题,数据进行更新
- 回滚:出现问题,数据恢复到开启事务时的状态
例子:
CREATE TABLE account (
	id INT PRIMARY KEY AUTO_INCREMENT,
	NAME VARCHAR(10),
	balance DOUBLE
);
-- 添加数据
INSERT INTO account (NAME, balance) VALUES (‘zhangsan‘, 1000), (‘lisi‘, 1000);
INSERT INTO account (NAME, balance) VALUES (‘lisi‘, 1000), (‘lisi‘, 1000);
-- 张三向李四转账500
-- 开启事务,通知执行账户的增减
START TRANSACTION;
UPDATE account SET balance = balance - 500 WHERE NAME = ‘zhangsan‘;
UPDATE account SET balance = balance + 500 WHERE NAME = ‘lisi‘;
-- 发现执行没有问题,提交事务
COMMIT;
-- 发现出问题了,回滚事务
ROLLBACK;
事务的提交方式
MySQL数据库中事务默认自动提交。就是每执行一条语句就提交一次。Oracle默认手动提交,需要先开启事务,再commit。
修改事务默认提交方式:
- 查看默认提交方式:SELECT @@autocommit; -- 1 代表自动提交 0 代表手动提交
- 修改默认提交方式: set @@autocommit = 0;
事务的特征
- 原子性(atomicity)
- 原子性是指事务包含的所有操作要么全部成功,要么全部失败回滚,因此事务的操作如果成功就必须要完全应用到数据库,如果操作失败则不能对数据库有任何影响
- 一致性(consistency)
- 一致性是指事务必须使数据库从一个一致性状态变换到另一个一致性状态,也就是说一个事务执行之前和执行之后都必须处于一致性状态
- 拿转账来说,假设张三和李四两者的钱加起来一共是2000,那么不管A和B之间如何转账,转几次账,事务结束后两个用户的钱相加起来应该还得是2000,这就是事务的一致性
- 隔离性(isolcation)
- 隔离性是当多个用户并发访问数据库时,比如操作同一张表时,数据库为每一个用户开启的事务,不能被其他事务的操作所干扰,多个并发事务之间要相互隔离
- 持久性(durability)
- 持久性是指一个事务一旦被提交了,那么对数据库中的数据的改变就是永久性的,即便是在数据库系统遇到故障的情况下也不会丢失提交事务的操作
事务的隔离级别
多个事务之间隔离的,相互独立的。但是如果多个事务操作同一批数据,则会引发一些问题,设置不同的隔离级别就可以解决这些问题。
存在问题:
- 脏读:一个事务,读取到另一个事务中没有提交的数据
- 不可重复读(虚读):在同一个事务中,两次读取到的数据不一样。
- 幻读:select 某记录是否存在,不存在,准备插入此记录,但执行 insert 时发现此记录已存在,无法插入。或不存在执行delete删除,却发现删除成功
隔离级别:
- read uncommitted:读未提交。产生的问题:脏读、不可重复读、幻读
- read committed:读已提交(Oracle)。产生的问题:不可重复读、幻读
- repeatable read:可重复读(MySQL默认)。产生的问题:幻读
- serializable:串行化。可以解决所有的问题
- 注意:隔离级别从小到大安全性越来越高,但是效率越来越低
- 数据库查询隔离级别:select @@tx_isolation;
- 数据库设置隔离级别:set global transaction isolation level 级别字符串;
存储引擎
MySQL数据库使用不同的机制存取表文件 , 机制的差别在于不同的存储方式、索引技巧、锁定水平以及广泛的不同的功能和能力,在MySQL中 , 将这些不同的技术及配套的功能称为存储引擎。
在关系型数据库中数据的存储是以表的形式存进行储的,所以存储引擎也可以称为表类型(即存储和操作此表的类型)。
Oracle , SqlServer等数据库只有一种存储引擎 , 而MySQL针对不同的需求, 配置MySQL的不同的存储引擎 , 就会让数据库采取了不同的处理数据的方式和扩展功能。
通过选择不同的引擎 ,能够获取最佳的方案 , 也能够获得额外的速度或者功能,提高程序的整体效果。所以了解引擎的特性 , 才能贴合我们的需求 , 更好的发挥数据库的性能。
MySQL5.7支持的引擎包括:InnoDB、MyISAM、MEMORY、Archive、Federate、CSV、BLACKHOLE等
其中较为常用的有三种:InnoDB、MyISAM、MEMORY
| 特性 | MyISAM | InnoDB | MEMORY |
|---|---|---|---|
| 存储限制 | 有(平台对文件系统大小的限制) | 64TB | 有(平台的内存限制) |
| 事务安全 | 不支持 | 支持 | 不支持 |
| 锁机制 | 表锁 | 表锁/行锁 | 表锁 |
| B+Tree索引 | 支持 | 支持 | 支持 |
| 哈希索引 | 不支持 | 不支持 | 支持 |
| 全文索引 | 支持 | 支持 | 不支持 |
| 集群索引 | 不支持 | 支持 | 不支持 |
| 数据索引 | 不支持 | 支持 | 支持 |
| 数据缓存 | 不支持 | 支持 | N/A |
| 索引缓存 | 支持 | 支持 | N/A |
| 数据可压缩 | 支持 | 不支持 | 不支持 |
| 空间使用 | 低 | 高 | N/A |
| 内存使用 | 低 | 高 | 中等 |
| 批量插入速度 | 高 | 低 | 高 |
| 外键 | 不支持 | 支持 | 不支持 |
引擎操作
- 查询数据库支持的引擎
-- 标准语法
SHOW ENGINES;

-- 查询数据库支持的存储引擎
SHOW ENGINES;
-- 表含义:
  - support : 指服务器是否支持该存储引擎
  - transactions : 指存储引擎是否支持事务
  - XA : 指存储引擎是否支持分布式事务处理
  - Savepoints : 指存储引擎是否支持保存点
- 查询某个数据库中所有数据表的引擎
-- 标准语法
SHOW TABLE STATUS FROM 数据库名称;

-- 查看db9数据库所有表的存储引擎
SHOW TABLE STATUS FROM db9;
- 查询某个数据库中某个数据表的引擎
-- 标准语法
SHOW TABLE STATUS FROM 数据库名称 WHERE NAME = ‘数据表名称‘;

-- 查看db9数据库中stu_score表的存储引擎
SHOW TABLE STATUS FROM db9 WHERE NAME = ‘stu_score‘;
- 创建数据表,指定存储引擎
-- 标准语法
CREATE TABLE 表名(
	列名,数据类型,
    ...
)ENGINE = 引擎名称;

-- 创建db11数据库
CREATE DATABASE db11;

-- 使用db11数据库
USE db11;

-- 创建engine_test表,指定存储引擎为MyISAM
CREATE TABLE engine_test(
	id INT PRIMARY KEY AUTO_INCREMENT,
	NAME VARCHAR(10)
)ENGINE = MYISAM;

-- 查询engine_test表的引擎
SHOW TABLE STATUS FROM db11 WHERE NAME = ‘engine_test‘;
- 修改表的存储引擎
-- 标准语法
ALTER TABLE 表名 ENGINE = 引擎名称;

-- 修改engine_test表的引擎为InnoDB
ALTER TABLE engine_test ENGINE = INNODB;

-- 查询engine_test表的引擎
SHOW TABLE STATUS FROM db11 WHERE NAME = ‘engine_test‘;
引擎的选择
- MyISAM :由于MyISAM不支持事务、不支持外键、支持全文检索和表级锁定,读写相互阻塞,读取速度快,节约资源,所以如果应用是以查询操作和插入操作为主,只有很少的更新和删除操作,并且对事务的完整性、并发性要求不是很高,那么选择这个存储引擎是非常合适的。
- InnoDB : 是MySQL的默认存储引擎, 由于InnoDB支持事务、支持外键、行级锁定 ,支持所有辅助索引(5.5.5后不支持全文检索),高缓存,所以用于对事务的完整性有比较高的要求,在并发条件下要求数据的一致性,读写频繁的操作,那么InnoDB存储引擎是比较合适的选择,比如BBS、计费系统、充值转账等
- MEMORY:将所有数据保存在RAM中,在需要快速定位记录和其他类似数据环境下,可以提供更快的访问。MEMORY的缺陷就是对表的大小有限制,太大的表无法缓存在内存中,其次是要确保表的数据可以恢复,数据库异常终止后表中的数据是可以恢复的。MEMORY表通常用于更新不太频繁的小表,用以快速得到访问结果。
- 总结:针对不同的需求场景,来选择最适合的存储引擎即可!如果不确定、则使用数据库默认的存储引擎!
索引
概念
- 我们之前学习过集合,其中的ArrayList集合的特点之一就是有索引。那么有索引会带来哪些好处呢?
- 没错,查询数据快!我们可以通过索引来快速查找到想要的数据。那么对于我们的MySQL数据库中的索引功能也是类似的!
- MySQL数据库中的索引:是帮助MySQL高效获取数据的一种数据结构!所以,索引的本质就是数据结构。
- 在表数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式指向数据, 这样就可以在这些数据结构上实现高级查找算法,这种数据结构就是索引。
- 一张数据表,用于保存数据。 一个索引配置文件,用于保存索引,每个索引都去指向了某一个数据(表格演示)
- 举例,无索引和有索引的查找原理

分类
- 功能分类
- 普通索引: 最基本的索引,它没有任何限制。
- 唯一索引:索引列的值必须唯一,但允许有空值。如果是组合索引,则列值组合必须唯一。
- 主键索引:一种特殊的唯一索引,不允许有空值。一般在建表时同时创建主键索引。
- 组合索引:顾名思义,就是将单列索引进行组合。
- 外键索引:只有InnoDB引擎支持外键索引,用来保证数据的一致性、完整性和实现级联操作。
- 全文索引:快速匹配全部文档的方式。InnoDB引擎5.6版本后才支持全文索引。MEMORY引擎不支持。
- 结构分类
- B+Tree索引 :MySQL使用最频繁的一个索引数据结构,是InnoDB和MyISAM存储引擎默认的索引类型。
- Hash索引 : MySQL中Memory存储引擎默认支持的索引类型。
索引的操作
- 数据准备
-- 创建db12数据库
CREATE DATABASE db12;

-- 使用db12数据库
USE db12;

-- 创建student表
CREATE TABLE student(
	id INT PRIMARY KEY AUTO_INCREMENT,
	NAME VARCHAR(10),
	age INT,
	score INT
);
-- 添加数据
INSERT INTO student VALUES (NULL,‘张三‘,23,98),(NULL,‘李四‘,24,95),
(NULL,‘王五‘,25,96),(NULL,‘赵六‘,26,94),(NULL,‘周七‘,27,99);
- 创建索引
- 注意:如果一个表中有一列是主键,那么就会默认为其创建主键索引!(主键列不需要单独创建索引)
-- 标准语法
CREATE [UNIQUE|FULLTEXT] INDEX 索引名称
[USING 索引类型]  -- 默认是B+TREE
ON 表名(列名...);

-- 为student表中姓名列创建一个普通索引
CREATE INDEX idx_name ON student(NAME);

-- 为student表中年龄列创建一个唯一索引
CREATE UNIQUE INDEX idx_age ON student(age);
- 查看索引
-- 标准语法
SHOW INDEX FROM 表名;

-- 查看student表中的索引
SHOW INDEX FROM student;
- alter语句添加索引
-- 普通索引
ALTER TABLE 表名 ADD INDEX 索引名称(列名);

-- 组合索引
ALTER TABLE 表名 ADD INDEX 索引名称(列名1,列名2,...);

-- 主键索引
ALTER TABLE 表名 ADD PRIMARY KEY(主键列名);

-- 外键索引(添加外键约束,就是外键索引)
ALTER TABLE 表名 ADD CONSTRAINT 外键名 FOREIGN KEY (本表外键列名) REFERENCES 主表名(主键列名);

-- 唯一索引
ALTER TABLE 表名 ADD UNIQUE 索引名称(列名);

-- 全文索引(mysql只支持文本类型)
ALTER TABLE 表名 ADD FULLTEXT 索引名称(列名);

-- 为student表中name列添加全文索引
ALTER TABLE student ADD FULLTEXT idx_fulltext_name(name);

-- 查看student表中的索引
SHOW INDEX FROM student;
- 删除索引
-- 标准语法
DROP INDEX 索引名称 ON 表名;

-- 删除student表中的idx_score索引
DROP INDEX idx_score ON student;

-- 查看student表中的索引
SHOW INDEX FROM student;
索引效率的测试
-- 创建product商品表
CREATE TABLE product(
	id INT PRIMARY KEY AUTO_INCREMENT,  -- 商品id
	NAME VARCHAR(10),		    -- 商品名称
	price INT                           -- 商品价格
);

-- 定义存储函数,生成长度为10的随机字符串并返回
DELIMITER $

CREATE FUNCTION rand_string()
RETURNS VARCHAR(255)
BEGIN
	DECLARE big_str VARCHAR(100) DEFAULT ‘abcdefghijklmnopqrstuvwxyzABCDEFGHIGKLMNOPQRSTUVWXYZ‘;
	DECLARE small_str VARCHAR(255) DEFAULT ‘‘;
	DECLARE i INT DEFAULT 1;

	WHILE i <= 10 DO
		SET small_str =CONCAT(small_str,SUBSTRING(big_str,FLOOR(1+RAND()*52),1));
		SET i=i+1;
	END WHILE;

	RETURN small_str;
END$

DELIMITER ;


-- 定义存储过程,添加100万条数据到product表中
DELIMITER $

CREATE PROCEDURE pro_test()
BEGIN
	DECLARE num INT DEFAULT 1;

	WHILE num <= 1000000 DO
		INSERT INTO product VALUES (NULL,rand_string(),num);
		SET num = num + 1;
	END WHILE;
END$

DELIMITER ;

-- 调用存储过程
CALL pro_test();


-- 查询总记录条数
SELECT COUNT(*) FROM product;


-- 查询product表的索引
SHOW INDEX FROM product;

-- 查询name为OkIKDLVwtG的数据   (0.049)
SELECT * FROM product WHERE NAME=‘OkIKDLVwtG‘;

-- 通过id列查询OkIKDLVwtG的数据  (1毫秒)
SELECT * FROM product WHERE id=999998;

-- 为name列添加索引
ALTER TABLE product ADD INDEX idx_name(NAME);

-- 查询name为OkIKDLVwtG的数据   (0.001)
SELECT * FROM product WHERE NAME=‘OkIKDLVwtG‘;


/*
	范围查询
*/
-- 查询价格为800~1000之间的所有数据 (0.052)
SELECT * FROM product WHERE price BETWEEN 800 AND 1000;

/*
	排序查询
*/
-- 查询价格为800~1000之间的所有数据,降序排列  (0.083)
SELECT * FROM product WHERE price BETWEEN 800 AND 1000 ORDER BY price DESC;

-- 为price列添加索引
ALTER TABLE product ADD INDEX idx_price(price);

-- 查询价格为800~1000之间的所有数据 (0.011)
SELECT * FROM product WHERE price BETWEEN 800 AND 1000;

-- 查询价格为800~1000之间的所有数据,降序排列  (0.001)
SELECT * FROM product WHERE price BETWEEN 800 AND 1000 ORDER BY price DESC;
索引的实现原则
- 索引是在MySQL的存储引擎中实现的,所以每种存储引擎的索引不一定完全相同,也不是所有的引擎支持所有的索引类型。这里我们主要介绍InnoDB引擎的实现的B+Tree索引。
- B+Tree是一种树型数据结构,是B-Tree的变种。通常使用在数据库和操作系统中的文件系统,特点是能够保持数据稳定有序。我们逐步的来了解一下。
磁盘存储
- 系统从磁盘读取数据到内存时是以磁盘块(block)为基本单位的
- 位于同一个磁盘块中的数据会被一次性读取出来,而不是需要什么取什么。
- InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位。InnoDB存储引擎中默认每个页的大小为16KB。
- InnoDB引擎将若干个地址连接磁盘块,以此来达到页的大小16KB,在查询数据时如果一个页中的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率。
BTree
-
BTree结构的数据可以让系统高效的找到数据所在的磁盘块。为了描述BTree,首先定义一条记录为一个二元组[key, data] ,key为记录的键值,对应表中的主键值,data为一行记录中除主键外的数据。对于不同的记录,key值互不相同。BTree中的每个节点根据实际情况可以包含大量的关键字信息和分支,如下图所示为一个3阶的BTree:

-
根据图中结构显示,每个节点占用一个盘块的磁盘空间,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为17和35,P1指针指向的子树的数据范围为小于17,P2指针指向的子树的数据范围为17~35,P3指针指向的子树的数据范围为大于35。
查找顺序:
模拟查找15的过程 :

1.根节点找到磁盘块1,读入内存。【磁盘I/O操作第1次】
	比较关键字15在区间(<17),找到磁盘块1的指针P1。
2.P1指针找到磁盘块2,读入内存。【磁盘I/O操作第2次】
	比较关键字15在区间(>12),找到磁盘块2的指针P3。
3.P3指针找到磁盘块7,读入内存。【磁盘I/O操作第3次】
	在磁盘块7中找到关键字15。

-- 分析上面过程,发现需要3次磁盘I/O操作,和3次内存查找操作。
-- 由于内存中的关键字是一个有序表结构,可以利用二分法查找提高效率。而3次磁盘I/O操作是影响整个BTree查找效率的决定因素。BTree使用较少的节点个数,使每次磁盘I/O取到内存的数据都发挥了作用,从而提高了查询效率。
B+Tree
- B+Tree是在BTree基础上的一种优化,使其更适合实现外存储索引结构,InnoDB存储引擎就是用B+Tree实现其索引结构。
- 从上一节中的BTree结构图中可以看到每个节点中不仅包含数据的key值,还有data值。而每一个页的存储空间是有限的,如果data数据较大时将会导致每个节点(即一个页)能存储的key的数量很小,当存储的数据量很大时同样会导致B-Tree的深度较大,增大查询时的磁盘I/O次数,进而影响查询效率。在B+Tree中,所有数据记录节点都是按照键值大小顺序存放在同一层的叶子节点上,而非叶子节点上只存储key值信息,这样可以大大加大每个节点存储的key值数量,降低B+Tree的高度。
- B+Tree相对于BTree区别:
- 非叶子节点只存储键值信息。
- 所有叶子节点之间都有一个连接指针。
- 数据记录都存放在叶子节点中。
- 将上一节中的BTree优化,由于B+Tree的非叶子节点只存储键值信息,假设每个磁盘块能存储4个键值及指针信息,则变成B+Tree后其结构如下图所示:

通常在B+Tree上有两个头指针,一个指向根节点,另一个指向关键字最小的叶子节点,而且所有叶子节点(即数据节点)之间是一种链式环结构。因此可以对B+Tree进行两种查找运算:
- 【有范围】对于主键的范围查找和分页查找
- 【有顺序】从根节点开始,进行随机查找
实际情况中每个节点可能不能填充满,因此在数据库中,B+Tree的高度一般都在24层。MySQL的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要13次磁盘I/O操作。
总结:索引的设计原则
索引的设计可以遵循一些已有的原则,创建索引的时候请尽量考虑符合这些原则,便于提升索引的使用效率,更高效的使用索引。
- 创建索引时的原则
- 对查询频次较高,且数据量比较大的表建立索引。
- 使用唯一索引,区分度越高,使用索引的效率越高。
- 索引字段的选择,最佳候选列应当从where子句的条件中提取,如果where子句中的组合比较多,那么应当挑选最常用、过滤效果最好的列的组合。
- 使用短索引,索引创建之后也是使用硬盘来存储的,因此提升索引访问的I/O效率,也可以提升总体的访问效率。假如构成索引的字段总长度比较短,那么在给定大小的存储块内可以存储更多的索引值,相应的可以有效的提升MySQL访问索引的I/O效率。
- 索引可以有效的提升查询数据的效率,但索引数量不是多多益善,索引越多,维护索引的代价自然也就水涨船高。对于插入、更新、删除等DML操作比较频繁的表来说,索引过多,会引入相当高的维护代价,降低DML操作的效率,增加相应操作的时间消耗。另外索引过多的话,MySQL也会犯选择困难病,虽然最终仍然会找到一个可用的索引,但无疑提高了选择的代价。
- 联合索引的特点
在mysql建立联合索引时会遵循最左前缀匹配的原则,即最左优先,在检索数据时从联合索引的最左边开始匹配,
对列name列、address和列phone列建一个联合索引
ALTER TABLE user ADD INDEX index_three(name,address,phone);
联合索引index_three实际建立了(name)、(name,address)、(name,address,phone)三个索引。所以下面的三个SQL语句都可以命中索引。
SELECT * FROM user WHERE address = ‘北京‘ AND phone = ‘12345‘ AND name = ‘张三‘;
SELECT * FROM user WHERE name = ‘张三‘ AND address = ‘北京‘;
SELECT * FROM user WHERE name = ‘张三‘;
上面三个查询语句执行时会依照最左前缀匹配原则,检索时分别会使用索引
(name,address,phone)
(name,address)
(name)
进行数据匹配。
索引的字段可以是任意顺序的,如:
-- 优化器会帮助我们调整顺序,下面的SQL语句都可以命中索引
SELECT * FROM user WHERE address = ‘北京‘ AND phone = ‘12345‘ AND name = ‘张三‘;
Mysql的优化器会帮助我们调整where条件中的顺序,以匹配我们建立的索引。
联合索引中最左边的列不包含在条件查询中,所以根据上面的原则,下面的SQL语句就不会命中索引。
-- 联合索引中最左边的列不包含在条件查询中,下面的SQL语句就不会命中索引
SELECT * FROM user WHERE address = ‘北京‘ AND phone = ‘12345‘;
锁
概念
-
之前我们学习过多线程,多线程当中如果想保证数据的准确性是如何实现的呢?没错,通过同步实现。同步就相当于是加锁。加了锁以后有什么好处呢?当一个线程真正在操作数据的时候,其他线程只能等待。当一个线程执行完毕后,释放锁。其他线程才能进行操作!
-
那么我们的MySQL数据库中的锁的功能也是类似的。在我们学习事务的时候,讲解过事务的隔离性,可能会出现脏读、不可重复读、幻读的问题,当时我们的解决方式是通过修改事务的隔离级别来控制,但是数据库的隔离级别呢我们并不推荐修改。所以,锁的作用也可以解决掉之前的问题!
-
锁机制 : 数据库为了保证数据的一致性,而使用各种共享的资源在被并发访问时变得有序所设计的一种规则。
-
举例,在电商网站购买商品时,商品表中只存有1个商品,而此时又有两个人同时购买,那么谁能买到就是一个关键的问题。
这里会用到事务进行一系列的操作:
- 先从商品表中取出物品的数据
- 然后插入订单
- 付款后,再插入付款表信息
- 更新商品表中商品的数量
以上过程中,使用锁可以对商品数量数据信息进行保护,实现隔离,即只允许第一位用户完成整套购买流程,而其他用户只能等待,这样就解决了并发中的矛盾问题。
-
在数据库中,数据是一种供许多用户共享访问的资源,如何保证数据并发访问的一致性、有效性,是所有数据库必须解决的一个问题,MySQL由于自身架构的特点,在不同的存储引擎中,都设计了面对特定场景的锁定机制,所以引擎的差别,导致锁机制也是有很大差别的。
分类
- 按操作分类:
- 共享锁:也叫读锁。针对同一份数据,多个事务读取操作可以同时加锁而不互相影响 ,但是不能修改数据记录。
- 排他锁:也叫写锁。当前的操作没有完成前,会阻断其他操作的读取和写入
- 按粒度分类:
- 表级锁:操作时,会锁定整个表。开销小,加锁快;不会出现死锁;锁定力度大,发生锁冲突概率高,并发度最低。偏向于MyISAM存储引擎!
- 行级锁:操作时,会锁定当前操作行。开销大,加锁慢;会出现死锁;锁定粒度小,发生锁冲突的概率低,并发度高。偏向于InnoDB存储引擎!
- 页级锁:锁的粒度、发生冲突的概率和加锁的开销介于表锁和行锁之间,会出现死锁,并发性能一般。
- 按使用方式分类:
- 悲观锁:每次查询数据时都认为别人会修改,很悲观,所以查询时加锁。
- 乐观锁:每次查询数据时都认为别人不会修改,很乐观,但是更新时会判断一下在此期间别人有没有去更新这个数据
- 不同存储引擎支持的锁
| 存储引擎 | 表级锁 | 行级锁 | 页级锁 |
|---|---|---|---|
| MyISAM | 支持 | 不支持 | 不支持 |
| InnoDB | 支持 | 支持 | 不支持 |
| MEMORY | 支持 | 不支持 | 不支持 |
| BDB | 支持 | 不支持 | 支持 |
InnoDB锁
- 数据准备
-- 创建db13数据库
CREATE DATABASE db13;

-- 使用db13数据库
USE db13;

-- 创建student表
CREATE TABLE student(
	id INT PRIMARY KEY AUTO_INCREMENT,
	NAME VARCHAR(10),
	age INT,
	score INT
);
-- 添加数据
INSERT INTO student VALUES (NULL,‘张三‘,23,99),(NULL,‘李四‘,24,95),
(NULL,‘王五‘,25,98),(NULL,‘赵六‘,26,97);
- 共享锁
-- 标准语法
SELECT语句 LOCK IN SHARE MODE;
-- 窗口1
/*
	共享锁:数据可以被多个事务查询,但是不能修改
*/
-- 开启事务
START TRANSACTION;

-- 查询id为1的数据记录。加入共享锁
SELECT * FROM student WHERE id=1 LOCK IN SHARE MODE;

-- 查询分数为99分的数据记录。加入共享锁
SELECT * FROM student WHERE score=99 LOCK IN SHARE MODE;

-- 提交事务
COMMIT;
-- 窗口2
-- 开启事务
START TRANSACTION;

-- 查询id为1的数据记录(普通查询,可以查询)
SELECT * FROM student WHERE id=1;

-- 查询id为1的数据记录,并加入共享锁(可以查询。共享锁和共享锁兼容)
SELECT * FROM student WHERE id=1 LOCK IN SHARE MODE;

-- 修改id为1的姓名为张三三(不能修改,会出现锁的情况。只有窗口1提交事务后,才能修改成功)
UPDATE student SET NAME=‘张三三‘ WHERE id = 1;

-- 修改id为2的姓名为李四四(修改成功,InnoDB引擎默认是行锁)
UPDATE student SET NAME=‘李四四‘ WHERE id = 2;

-- 修改id为3的姓名为王五五(注意:InnoDB引擎如果不采用带索引的列。则会提升为表锁)
UPDATE student SET NAME=‘王五五‘ WHERE id = 3;

-- 提交事务
COMMIT;
- 排他锁
-- 标准语法
SELECT语句 FOR UPDATE;
-- 窗口1
/*
	排他锁:加锁的数据,不能被其他事务加锁查询或修改
*/
-- 开启事务
START TRANSACTION;

-- 查询id为1的数据记录,并加入排他锁
SELECT * FROM student WHERE id=1 FOR UPDATE;

-- 提交事务
COMMIT;
-- 窗口2
-- 开启事务
START TRANSACTION;

-- 查询id为1的数据记录(普通查询没问题)
SELECT * FROM student WHERE id=1;

-- 查询id为1的数据记录,并加入共享锁(不能查询。因为排他锁不能和其他锁共存)
SELECT * FROM student WHERE id=1 LOCK IN SHARE MODE;

-- 查询id为1的数据记录,并加入排他锁(不能查询。因为排他锁不能和其他锁共存)
SELECT * FROM student WHERE id=1 FOR UPDATE;

-- 修改id为1的姓名为张三(不能修改,会出现锁的情况。只有窗口1提交事务后,才能修改成功)
UPDATE student SET NAME=‘张三‘ WHERE id=1;

-- 提交事务
COMMIT;
- 注意:锁的兼容性
- 共享锁和共享锁 兼容
- 共享锁和排他锁 冲突
- 排他锁和排他锁 冲突
- 排他锁和共享锁 冲突
MyISAM锁
- 数据准备
-- 创建product表
CREATE TABLE product(
	id INT PRIMARY KEY AUTO_INCREMENT,
	NAME VARCHAR(20),
	price INT
)ENGINE = MYISAM;  -- 指定存储引擎为MyISAM

-- 添加数据
INSERT INTO product VALUES (NULL,‘华为手机‘,4999),(NULL,‘小米手机‘,2999),
(NULL,‘苹果‘,8999),(NULL,‘中兴‘,1999);
- 读锁
-- 标准语法
-- 加锁
LOCK TABLE 表名 READ;

-- 解锁(将当前会话所有的表进行解锁)
UNLOCK TABLES;
-- 窗口1
/*
	读锁:所有连接只能读取数据,不能修改
*/
-- 为product表加入读锁
LOCK TABLE product READ;

-- 查询product表(查询成功)
SELECT * FROM product;

-- 修改华为手机的价格为5999(修改失败)
UPDATE product SET price=5999 WHERE id=1;

-- 解锁
UNLOCK TABLES;
-- 窗口2
-- 查询product表(查询成功)
SELECT * FROM product;

-- 修改华为手机的价格为5999(不能修改,窗口1解锁后才能修改成功)
UPDATE product SET price=5999 WHERE id=1;
- 写锁
-- 标准语法
-- 加锁
LOCK TABLE 表名 WRITE;

-- 解锁(将当前会话所有的表进行解锁)
UNLOCK TABLES;
-- 窗口1
/*
	写锁:其他连接不能查询和修改数据
*/
-- 为product表添加写锁
LOCK TABLE product WRITE;

-- 查询product表(查询成功)
SELECT * FROM product;

-- 修改小米手机的金额为3999(修改成功)
UPDATE product SET price=3999 WHERE id=2;

-- 解锁
UNLOCK TABLES;
-- 窗口2
-- 查询product表(不能查询。只有窗口1解锁后才能查询成功)
SELECT * FROM product;

-- 修改小米手机的金额为2999(不能修改。只有窗口1解锁后才能修改成功)
UPDATE product SET price=2999 WHERE id=2;
悲观锁和乐观锁
-
悲观锁的概念
- 就是很悲观,它对于数据被外界修改的操作持保守态度,认为数据随时会修改。
- 整个数据处理中需要将数据加锁。悲观锁一般都是依靠关系型数据库提供的锁机制。
- 我们之前所学的行锁,表锁不论是读写锁都是悲观锁。
-
乐观锁的概念
- 就是很乐观,每次自己操作数据的时候认为没有人会来修改它,所以不去加锁。
- 但是在更新的时候会去判断在此期间数据有没有被修改。
- 需要用户自己去实现,不会发生并发抢占资源,只有在提交操作的时候检查是否违反数据完整性。
-
悲观锁和乐观锁使用前提
- 对于读的操作远多于写的操作的时候,这时候一个更新操作加锁会阻塞所有的读取操作,降低了吞吐量。最后还要释放锁,锁是需要一些开销的,这时候可以选择乐观锁。
- 如果是读写比例差距不是非常大或者系统没有响应不及时,吞吐量瓶颈的问题,那就不要去使用乐观锁,它增加了复杂度,也带来了业务额外的风险。这时候可以选择悲观锁。
-
乐观锁的实现方式
-
版本号
- 给数据表中添加一个version列,每次更新后都将这个列的值加1。
- 读取数据时,将版本号读取出来,在执行更新的时候,比较版本号。
- 如果相同则执行更新,如果不相同,说明此条数据已经发生了变化。
- 用户自行根据这个通知来决定怎么处理,比如重新开始一遍,或者放弃本次更新。
-- 创建city表 CREATE TABLE city( id INT PRIMARY KEY AUTO_INCREMENT, -- 城市id NAME VARCHAR(20), -- 城市名称 VERSION INT -- 版本号 ); -- 添加数据 INSERT INTO city VALUES (NULL,‘北京‘,1),(NULL,‘上海‘,1),(NULL,‘广州‘,1),(NULL,‘深圳‘,1); -- 修改北京为北京市 -- 1.查询北京的version SELECT VERSION FROM city WHERE NAME=‘北京‘; -- 2.修改北京为北京市,版本号+1。并对比版本号 UPDATE city SET NAME=‘北京市‘,VERSION=VERSION+1 WHERE NAME=‘北京‘ AND VERSION=1; -
时间戳
- 和版本号方式基本一样,给数据表中添加一个列,名称无所谓,数据类型需要是timestamp
- 每次更新后都将最新时间插入到此列。
- 读取数据时,将时间读取出来,在执行更新的时候,比较时间。
- 如果相同则执行更新,如果不相同,说明此条数据已经发生了变化。
-
锁的总结
-
表锁和行锁
- 行锁:锁的粒度更细,加行锁的性能损耗较大。并发处理能力较高。InnoDB引擎默认支持!
- 表锁:锁的粒度较粗,加表锁的性能损耗较小。并发处理能力较低。InnoDB、MyISAM引擎支持!
-
InnoDB锁优化建议
-
尽量通过带索引的列来完成数据查询,从而避免InnoDB无法加行锁而升级为表锁。
-
合理设计索引,索引要尽可能准确,尽可能的缩小锁定范围,避免造成不必要的锁定。
-
尽可能减少基于范围的数据检索过滤条件。
-
尽量控制事务的大小,减少锁定的资源量和锁定时间长度。
-
在同一个事务中,尽可能做到一次锁定所需要的所有资源,减少死锁产生概率。
-
对于非常容易产生死锁的业务部分,可以尝试使用升级锁定颗粒度,通过表级锁定来减少死锁的产生。
-
DCL管理用户
-
管理用户
-
添加用户:
ATE USER ‘用户名‘@‘主机名‘ IDENTIFIED BY ‘密码‘; -
删除用户:
DROP USER ‘用户名‘@‘主机名‘; -
修改用户
-
修改用户密码:
-- UPDATE USER SET PASSWORD = PASSWORD(‘新密码‘) WHERE USER = ‘用户名‘;
UPDATE USER SET PASSWORD = PASSWORD(‘abc‘) WHERE USER = ‘lisi‘;
-- SET PASSWORD FOR ‘用户名‘@‘主机名‘ = PASSWORD(‘新密码‘);
SET PASSWORD FOR ‘root‘@‘localhost‘ = PASSWORD(‘123‘);
忘记root用户的密码怎么办?
- 管理员运行cmd -- > net stop mysql 停止mysql服务
- 使用无验证方式启动mysql服务:mysqld --skip-grant-tables
- 打开新的cmd窗口,直接输入mysql命令,敲回车,就可以登录了
- use mysql; 所有的用户信息都保存在mysql库的user表中
- update user set password = password(‘你的新密码‘) where user = ‘root‘;
- 关闭两个窗口
- 打开任务管理器,手动结束mysqld.exe 的进程
- 启动mysql服务,使用新密码登录。
-
-
查询用户
use mysql;
SELECT * FROM USER;
-
-
权限管理:
-
查询权限:
SHOW GRANTS FOR ‘用户名‘@‘主机名‘;
SHOW GRANTS FOR ‘user01‘@‘%‘; -
授予权限:
grant 权限列表 on 数据库名.表名 to ‘用户名‘@‘主机名‘; grant select on db3.account to ‘zhangsan’@‘localhost’; -- 给张三用户授予所有权限,在任意数据库任意表上 GRANT ALL ON \*.\* TO ‘zhangsan‘@‘localhost‘;- 撤销权限:
revoke 权限列表 on 数据库名.表名 from ‘用户名‘@‘主机名‘; REVOKE UPDATE ON db3.`account` FROM ‘lisi‘@‘%‘; -
原文:https://www.cnblogs.com/yellowchives/p/15202924.html